[ENTRY.01 // WEB_CONSOLE]
DeepSeek网页版入口
免安装免登录在线体验 DeepSeek网页版。直面 DeepSeek-R1 满血版长思维链自省反思与代码高亮推演。
 CEREMONY // 仪式发布版
欢迎访问 DeepSeek官网。深度求索通过开创性的纯强化学习(Pure RL)与多头潜在注意力(MLA)架构,开创大模型自我验证与深层推演的新范式。自然交互融入 Deep Seek 智能底座,赋能全人类探索未至之境。
免安装免登录在线体验 DeepSeek网页版。直面 DeepSeek-R1 满血版长思维链自省反思与代码高亮推演。
标准 OpenAI SDK 格式直连。提供行业前沿极致性价比的高并发企业接口与 DeepSeek Harness 标准化评测套件。
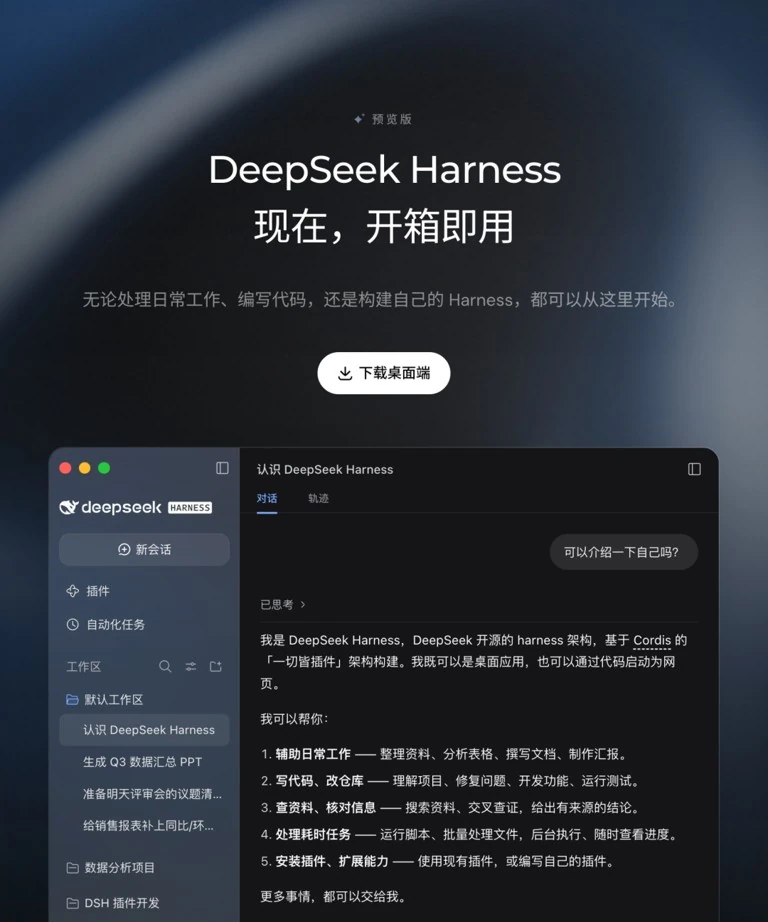
严格遵循官方 DeepSeek Harness 自动化评测规范复现
| 评测基准 (Benchmark) | 任务维度 | DeepSeek AI (纯RL)BEST | OpenAI o1-mini | Claude 3.5 Sonnet |
|---|---|---|---|---|
| MATH-500 | 高难度数学竞赛解题 | 97.3% | 90.0% | 78.3% |
| AIME 2024 | 美国数学邀请赛全真题 | 79.8% | 63.6% | 39.2% |
| Codeforces | 算法设计与竞技编程 | Rating 2029 (Top 3.7%) | Rating 1820 | Rating 1650 |
| GPQA Diamond | 博士级专业科学推理 | 71.5% | 60.0% | 65.0% |
| MMLU-Pro | 多学科综合跨域问答 | 84.0% | 80.3% | 78.9% |
在仪式庄重的技术探索中,构建低能耗极高吞吐的人工智能体系
大幅压缩键值缓存显存占用,使极致长文档上下文的高速自省与实时推演成为可能。
高达 671B 密集模型容量,每次仅激活 37B 参数,实现算力消耗与强劲性能的平衡。
全透明的自动化基准评测生态,让全球开发者能够独立复现和检验大模型真实水平。
摆脱对人工海量监督数据的依赖,让模型自发演化出反思、纠错与回溯验证的思维链。